

Die Entwicklung eines robusten Datenmodells ist nicht nur eine akademische Übung; es ist das Fundament, auf dem die Stabilität der Anwendung ruht. Ein Entity-Relationship-Diagramm (ERD) dient als Bauplan dafür, wie Informationen in einer Produktionsumgebung gespeichert, verknüpft und abgerufen werden. Wenn Systeme skalieren, steigen die Kosten schlechter Modellierung exponentiell. Dieser Leitfaden untersucht eine praktische Implementierung eines ERD innerhalb einer komplexen Backend-Architektur mit Fokus auf Datenintegrität, Skalierbarkeit und Wartbarkeit.
Zu oft konzentrieren sich Entwickler auf die Anwendungslogik und betrachten die Datenbank nur als nachrangiges Anliegen. Das Schema legt jedoch die Grenzen fest, innerhalb derer das System effizient arbeiten kann. Durch die Analyse eines realen Szenarios können wir die Kompromisse verstehen, die bei der Normalisierung von Daten, der Handhabung von Beziehungen und der Sicherstellung der referenziellen Integrität ohne Abhängigkeit von bestimmten Softwareanbietern involviert sind.
📋 Das Geschäftsszenario
Stellen Sie sich eine Multi-Tenant-Serviceplattform vor, die zur Verwaltung kollaborativer Projekte entwickelt wurde. Das System erfordert eine strenge Isolation zwischen verschiedenen Mandantenorganisationen, erlaubt jedoch interne Flexibilität innerhalb dieser Organisationen. Die Kernanforderungen umfassen:
- Multi-Tenancy:Daten müssen nach Organisation getrennt werden, um die Sicherheit zu gewährleisten.
- Komplexe Workflows:Aufgaben müssen zugewiesen, verfolgt und bestimmten Projekten zugeordnet werden.
- Audit-Trails:Jede wesentliche Änderung eines Datensatzes muss zur Einhaltung von Compliance-Vorgaben protokolliert werden.
- Skalierbarkeit:Das Schema muss Millionen von Datensätzen unterstützen, ohne die Abfrageleistung zu beeinträchtigen.
Die Herausforderung besteht darin, diese Geschäftsregeln in eine relationale Struktur zu übersetzen, die Datenanomalien verhindert. Ein häufiger Fehler ist die Erstellung übermäßig normalisierter Strukturen, die übermäßige Joins erfordern, oder übermäßig denormalisierter Strukturen, die zu Datenredundanz und Update-Anomalien führen.
🔍 Kernentitäten und Attribute
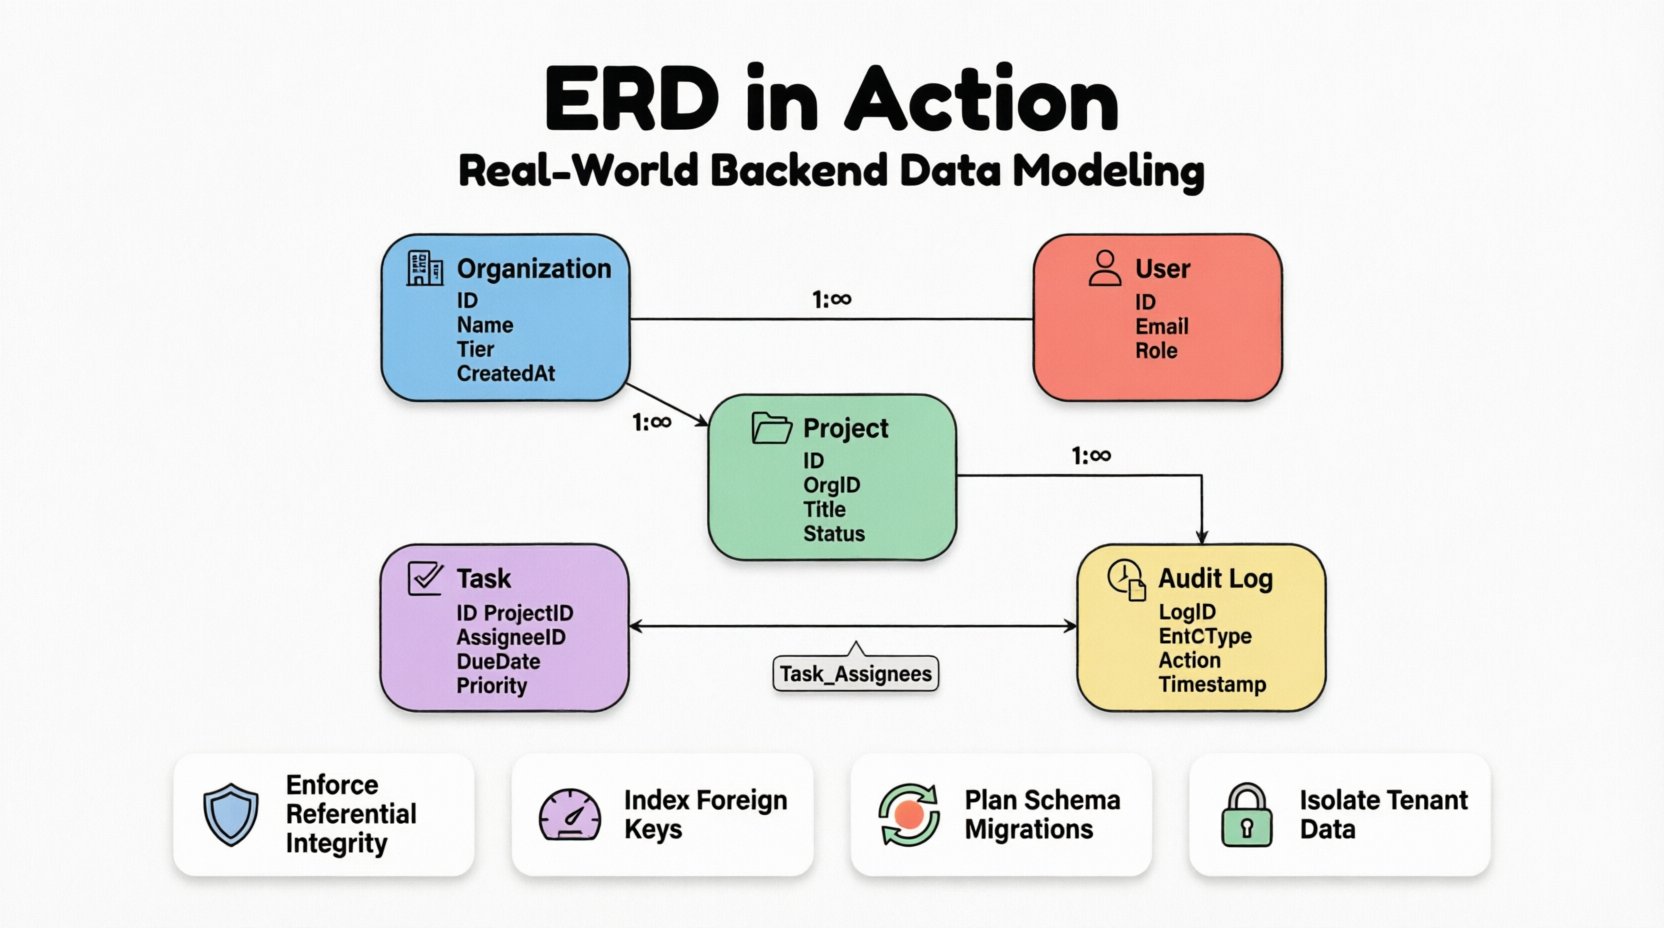
Das Rückgrat jedes ERD ist die Definition von Entitäten. In dieser Fallstudie identifizieren wir fünf primäre Entitäten. Jede Entität repräsentiert ein distinctes Konzept, das in der Datenbank gespeichert werden muss. Die mit diesen Entitäten verbundenen Attribute definieren die Granularität der gespeicherten Daten.
1. Organisation-Entität
Dies ist die Wurzel der Hierarchie. Jeder andere Datensatz ist mit dieser Entität verknüpft, um die Mandantenisolation durchzusetzen.
- Organisations-ID:Eindeutiger Bezeichner.
- Organisationsname:Menschlich lesbares Label.
- Abonnement-Stufe:Bestimmt den Zugriff auf Funktionen.
- Erstellt am:Zeitstempel für Audits.
2. Benutzer-Entität
Benutzer gehören zu Organisationen, können jedoch Mitglied mehrerer Projekte sein. Authentifizierungsdetails werden von Geschäftsdaten getrennt, um Sicherheitsbest Practices einzuhalten.
- Benutzer-ID:Eindeutiger Bezeichner.
- E-Mail: Wird zur Authentifizierung und Kontaktaufnahme verwendet.
- Passwort-Hash: Sichere Speicherung von Zugangsdaten.
- Rolle: Definiert Berechtigungen (Administrator, Mitglied, Betrachter).
3. Projekt-Entität
Projekte sind Container für Arbeitsaufgaben. Sie gehören einer Organisation, werden jedoch von Benutzern bearbeitet.
- Projekt-ID: Eindeutige Kennung.
- Organisations-ID: Fremdschlüssel, der auf den übergeordneten Mandanten verweist.
- Titel: Kurzer Name für das Projekt.
- Status: Aktiv, Archiviert oder Gelöscht.
4. Aufgaben-Entität
Die Grundeinheit der Arbeit. Diese Entität erfordert die komplexesten Beziehungen, da sie Benutzer, Projekte und Protokolle verknüpft.
- Aufgaben-ID: Eindeutige Kennung.
- Projekt-ID: Fremdschlüssel.
- Zugewiesene-ID: Fremdschlüssel auf Benutzer.
- Fälligkeitsdatum: Zeitliche Einschränkung.
- Priorität: Aufgezählter Wert.
5. Audit-Protokoll-Entität
Dokumentiert jede Änderung an kritischen Entitäten. Dies gewährleistet die Nachverfolgbarkeit.
- Protokoll-ID: Eindeutiger Bezeichner.
- Entitätstyp: Welche Tabelle betroffen war.
- Datensatz-ID: Welche Zeile betroffen war.
- Aktion: Erstellen, Aktualisieren, Löschen.
- Durchgeführt von: Benutzer-ID.
- Zeitstempel: Zeitpunkt der Aktion.
🔗 Modellierung von Beziehungen und Kardinalität
Beziehungen definieren, wie Entitäten interagieren. In einem Produktionssystem werden diese Beziehungen über Fremdschlüssel durchgesetzt. Die Kardinalität (eins-zu-eins, eins-zu-viele, viele-zu-viele) bestimmt, wie Daten abgefragt und aktualisiert werden.
Organisation zu Benutzer
Dies ist eine Eins-zu-Viele Beziehung. Eine Organisation kann viele Benutzer haben, aber ein Benutzerdatensatz ist aus Gründen der Datenisolierung an eine einzige Organisation gebunden. Um Datenlecks zwischen Mandanten zu verhindern, ist die organization_id ein obligatorischer Fremdschlüssel in der Tabelle Benutzer.
Organisation zu Projekt
Ähnlich ist dies eine Eins-zu-Viele Beziehung. Projekte können nicht ohne eine übergeordnete Organisation existieren. Wenn eine Organisation gelöscht wird, muss das Kaskadenverhalten sorgfältig berücksichtigt werden. In diesem Fall entscheiden wir uns, Projekte soft zu löschen, anstatt sie hart zu löschen, um den historischen Kontext zu bewahren.
Projekt zu Aufgabe
Eine weitere Eins-zu-Viele Beziehung. Ein Projekt enthält mehrere Aufgaben, und eine Aufgabe gehört genau zu einem Projekt. Dies ist eine standardmäßige strukturelle Verknüpfung.
Benutzer zu Aufgabe (Zuweisung)
Dies ist die kritischste Beziehung. Ein Benutzer kann mehreren Aufgaben zugewiesen werden, und eine Aufgabe kann mehreren Benutzern zugewiesen werden (kooperative Arbeit). Dies erfordert eine Viele-zu-Viele Beziehung.
Um dies umzusetzen, führen wir eine Verbindungstabelle ein, die oft als Assoziationsentität bezeichnet wird. Diese Tabelle zerlegt die Viele-zu-Viele-Beziehung in zwei Eins-zu-Viele-Beziehungen.
| Tabellenname | Zweck | Schlüssel |
|---|---|---|
| Task_Assignees | Verknüpft Benutzer mit Aufgaben | Task_ID, User_ID |
| Organization_Tenants | Verknüpft Organisationen mit Benutzern | Organization_ID, User_ID |
Die Verwendung einer Verbindungstabelle ermöglicht es uns, zusätzliche Metadaten zu speichern. Zum Beispiel können wir in der Task_Assignees Tabelle die Rolle speichern, die der Benutzer bei dieser spezifischen Aufgabe hatte (z. B. Lead, Mitwirkender), was sich von seiner globalen Benutzerrolle unterscheidet.
⚖️ Einschränkungen und Datenintegrität
Validierungen auf Anwendungsebene reichen nicht aus. Datenbankbeschränkungen fungieren als letzte Verteidigungslinie gegen Datenkorruption. In einer Produktionsumgebung sollten Beschränkungen auf Schemaebene definiert werden.
Referenzielle Integrität
Fremdschlüssel stellen sicher, dass ein Datensatz in einer Kindtabelle keinen nicht existierenden Elterndatensatz referenzieren kann. Beispielsweise kann eine Aufgabe keinem Benutzer zugewiesen werden, der nicht im System existiert.
Allerdings sind die ON DELETE und ON UPDATE Verhalten sind entscheidende Entscheidungen:
- CASCADE: Wenn ein Elterndatensatz gelöscht wird, werden alle Kinddatensätze gelöscht. Verwenden Sie dies für verwaiste Daten, die ohne den Elterndatensatz keine Bedeutung haben (z. B. Kommentare zu einem gelöschten Beitrag).
- RESTRICT: Verhindert das Löschen, wenn Kinddatensätze existieren. Verwenden Sie dies, um versehentlichen Datenverlust zu verhindern (z. B. das Löschen einer Organisation mit aktiven Abrechnungsdatensätzen).
- SET NULL: Wenn der Elterndatensatz gelöscht wird, wird die Fremdschlüsselspalte im Kinddatensatz auf NULL gesetzt. Verwenden Sie dies, wenn die Beziehung optional ist.
Check-Constraints
Standard SQL unterstützt Check-Constraints, um domänenspezifische Regeln durchzusetzen. Beispiele hierfür sind:
- Fälligkeitsdatum: Die
due_dateSpalte muss größer sein als diecreated_atSpalte. - Priorität: Die
prioritySpalte muss mit einer bestimmten Liste zulässiger Werte übereinstimmen (z. B. Niedrig, Mittel, Hoch). - Betrag: Finanzfelder müssen nicht-negativ sein.
Eindeutigkeitseinschränkungen
Stellen Sie die Eindeutigkeit der Daten dort sicher, wo dies erforderlich ist. Beispielsweise muss eine E-Mail-Adresse im gesamten System oder innerhalb einer bestimmten Organisation, je nach Benutzermodell, eindeutig sein. Eine zusammengesetzte Eindeutigkeitseinschränkung kann sicherstellen, dass ein Benutzer nur einmal einem bestimmten Projekt zugewiesen wird (Vermeidung doppelter Zuweisungen).
🚀 Leistungs- und Indexierungsstrategie
Ein gut entworfenes Schema ist nutzlos, wenn Abfragen langsam sind. Indexierung ist der Mechanismus, der es der Datenbank ermöglicht, Daten schnell zu finden. Indexe haben jedoch Kosten in Bezug auf Schreibleistung und Speicherplatz.
Identifizierung von Abfragemustern
Bevor Indizes erstellt werden, analysieren Sie die häufigsten Lesevorgänge. In unserem Fallbeispiel umfassen typische Abfragen:
- Alle Aufgaben finden, die einem bestimmten Benutzer zugewiesen sind.
- Alle Projekte innerhalb einer Organisation finden.
- Audit-Logs für eine bestimmte Entitäts-ID abrufen.
Indexplatzierung
Fremdschlüssel sind die häufigsten Kandidaten für die Indexierung. Wenn eine Abfrage häufig nach organization_id ist ein Index auf dieser Spalte zwingend erforderlich. Ohne ihn führt die Datenbank einen vollständigen Tabellenscan durch, der mit wachsenden Datenmengen schnell an Leistung verliert.
Zusammengesetzte Indizes sind nützlich für Abfragen, die nach mehreren Spalten filtern. Wenn das System beispielsweise häufig nach Aufgaben nach project_id UND Status, ist ein zusammengesetzter Index auf (project_id, status) effizienter als zwei separate Indizes.
Teilindizes
In Szenarien, in denen nur ein Teil der Daten häufig abgefragt wird, sparen Teilindizes Speicherplatz. Wenn das System beispielsweise nur nach aktiven Aufgaben sucht, ist ein Index, der nur Zeilen enthält, bei denen status = 'Aktiv' deutlich kleiner sein und schneller durchlaufen werden als ein Index auf die gesamte Tabelle.
🛠️ Wartung und Schema-Evolution
Softwareanforderungen ändern sich. Das Datenbank-Schema ist keine Ausnahme. Der Wechsel von Version A zu Version B erfordert sorgfältige Planung, um Ausfallzeiten und Datenverlust zu vermeiden. Dieser Prozess wird häufig über Migrations-Skripte verwaltet.
Hinzufügen von Spalten
Das Hinzufügen einer neuen Spalte ist im Allgemeinen sicher. Wenn die Spalte NULL-Werte zulässt, werden bestehende Zeilen nicht beeinflusst. Wenn die Spalte einen Standardwert erfordert, stellen Sie sicher, dass der Standardwert auf alle vorhandenen Daten anwendbar ist, um Verletzungen von Constraints zu vermeiden.
Entfernen von Spalten
Das Löschen einer Spalte ist riskant. Es ist besser, die Spalte zunächst als veraltet zu markieren. Dies ermöglicht es Entwicklern, Referenzen auf die Spalte im Anwendungscode zu entfernen, bevor sie sie physisch aus der Datenbank löschen. Dieser zweistufige Ansatz verhindert Anwendungsfehler während des Bereitstellungszeitraums.
Umbenennen von Spalten
Das Umbenennen von Spalten wird in älteren Datenbankversionen selten ohne komplexe Workarounds unterstützt. Es ist oft besser, eine neue Spalte mit dem gewünschten Namen hinzuzufügen, die Daten zu migrieren und dann die alte Spalte zu entfernen. Dies stellt sicher, dass das Schema während des Übergangs abwärtskompatibel bleibt.
🚧 Häufige Fallstricke beim ERD-Design
Selbst erfahrene Architekten machen Fehler. Das Verständnis häufiger Fallstricke hilft, diese während der Designphase zu vermeiden.
- Über-Normalisierung:Die Aufteilung von Daten in zu viele kleine Tabellen macht Abfragen komplex und langsam. Balancieren Sie die Normalisierung mit den Anforderungen an die Abfrageleistung.
- Unter-Normalisierung:Die Speicherung derselben Daten an mehreren Orten (z. B. wiederholte Benutzernamen in jedem Aufgabenprotokoll) führt zu Update-Anomalien. Wenn ein Benutzer seinen Namen ändert, müssen Sie jeden Protokolleintrag aktualisieren.
- Zyklische Abhängigkeiten:Das Erstellen zyklischer Fremdschlüsselbeziehungen kann zu Deadlocks beim Einfügen oder Löschen führen. Stellen Sie sicher, dass der Abhängigkeitsgraph ein gerichteter azyklischer Graph (DAG) ist.
- Ignorieren von Soft Deletes:Das harte Löschen von Datensätzen entfernt die Historie. Implementieren Sie eine
deleted_atZeitstempel-Spalte, um Datensätze für Audits sichtbar zu halten, sie jedoch aus Standardansichten auszublenden. - Implizite Datentypen:Die Verwendung generischer Typen wie
VARCHAR(255)für alles verschwendet Speicherplatz. Verwenden SieINTfür IDs,BOOLEANfür Flags und spezifische Längenbeschränkungen für Zeichenketten, wo angemessen.
✅ Best Practices für Produktions-ERDs
Um die Langlebigkeit und Gesundheit des Systems zu gewährleisten, halten Sie sich an diese Richtlinien:
- Beziehungen dokumentieren: Das ERD selbst ist Dokumentation. Stellen Sie sicher, dass es mit dem tatsächlichen Schema auf dem neuesten Stand ist. Automatisierte Tools können Diagramme aus der Datenbank generieren, um die Genauigkeit zu überprüfen.
- Namenskonventionen standardisieren: Verwenden Sie
snake_casefür Tabellen und Spalten. Präfixieren Sie Fremdschlüssel mit dem Beziehungsname (z. B.organization_idstatt nurorg_id) für Klarheit. - UUIDs vs. Auto-Inkrementierung verwenden: Für verteilte Systeme verhindern UUIDs Kollisionsprobleme beim Zusammenführen von Datenbanken. Für Single-Instance-Systeme sind inkrementierende Ganzzahlen kompakter und schneller.
- Für Wachstum planen: Entwerfen Sie unter Berücksichtigung der Partitionierung. Wenn eine Tabelle auf Milliarden von Zeilen wachsen soll, überlegen Sie, wie sie basierend auf dem
organization_id. - Zugriffsmuster überprüfen: Überprüfen Sie regelmäßig die Logs langsamer Abfragen, um fehlende Indizes oder ineffiziente Joins zu identifizieren.
🔄 Der Lebenszyklus eines Schemas
Ein ERD ist kein statisches Dokument. Es entwickelt sich mit dem Produkt. Der Lebenszyklus folgt typischerweise diesen Phasen:
- Entwurfsphase: Entwurf des ersten Modells basierend auf den Anforderungen.
- Implementierungsphase:Erstellung von Migrationsskripts zum Aufbau des Schemas.
- Validierungsphase:Durchführung von Lasttests zur Überprüfung der Leistungsannahmen.
- Iterationsphase:Hinzufügen neuer Felder oder Beziehungen, wenn neue Funktionen eingeführt werden.
- Optimierungsphase:Verfeinerung von Indizes und Constraints basierend auf Produktionsdaten.
Während der Optimierungsphase können Sie feststellen, dass die ursprünglichen Annahmen zur Kardinalität falsch waren. Beispielsweise können Sie feststellen, dass eine Eins-zu-Viele-Beziehung in der Praxis tatsächlich eine Viele-zu-Vieleist, was eine Schemaänderung auf eine Verbindungstabelle erfordert. Dies unterstreicht die Bedeutung von Flexibilität im Design.
🛡️ Sicherheitsaspekte beim Schema-Design
Datensicherheit ist eng mit dem Schema-Design verknüpft. Richtlinien für Row-Level Security (RLS) basieren häufig auf der Struktur des ERD, um korrekt zu funktionieren. Wenn die organization_idnicht ordnungsgemäß indiziert und durchgesetzt wird, kann ein Benutzer aus Organisation A versehentlich Daten von Organisation B abfragen.
Darüber hinaus sollten sensible Daten getrennt werden. Wenn das System Zahlungsdaten verarbeitet, sollten diese idealerweise in einem separaten Schema oder einer separaten Tabelle mit strengeren Zugriffsbeschränkungen gespeichert werden, anstatt mit allgemeinen Benutzermetadaten vermischt zu werden. Dies begrenzt die Auswirkung im Falle einer Sicherheitsverletzung.
📝 Zusammenfassung der Designentscheidungen
Die folgende Tabelle fasst die wichtigsten Entscheidungen dieser Fallstudie und die Gründe dafür zusammen.
| Entscheidung | Option A | Option B (Ausgewählt) | Begründung |
|---|---|---|---|
| Multi-Tenancy | Separate Datenbanken | Gemeinsame Datenbank, gemeinsames Schema | Geringerer Betriebsaufwand; einfachere Verwaltung von tenant-übergreifender Analytik. |
| Löschen von Organisationen | Hard Delete | Soft Delete | Bewahrt historische Audit-Logs und verhindert Datenverlust zur Einhaltung von Compliance-Vorgaben. |
| Aufgabenzuweisungen | Einzelne Spalte | Verknüpfungstabelle | Ermöglicht mehrere Zuweisungsempfänger und verfolgt spezifische Rollen pro Zuweisung. |
| Primärschlüssel | Auto-Inkrement | UUIDs | Unterstützt eine zukünftige verteilte Architektur und erleichtert das Zusammenführen von Daten. |
Der Aufbau eines produktionsreifen Backends erfordert mehr als nur das Schreiben von Code. Es erfordert ein tiefes Verständnis davon, wie Daten fließen und wie sie strukturiert sind. Eine ERD ist die Karte, die diese Reise leitet. Durch die Befolgung dieser Prinzipien stellen Sie sicher, dass das System mit dem Wachstum des Unternehmens stabil, sicher und skalierbar bleibt.
Denken Sie daran: Das Ziel ist nicht, das komplexeste mögliche Diagramm zu erstellen, sondern dasjenige, das die Anforderungen der Anwendung am besten erfüllt und gleichzeitig die technische Schuld minimiert. Kontinuierliche Überprüfung und Anpassung sind entscheidend für die Aufrechterhaltung eines gesunden Datenökosystems.