

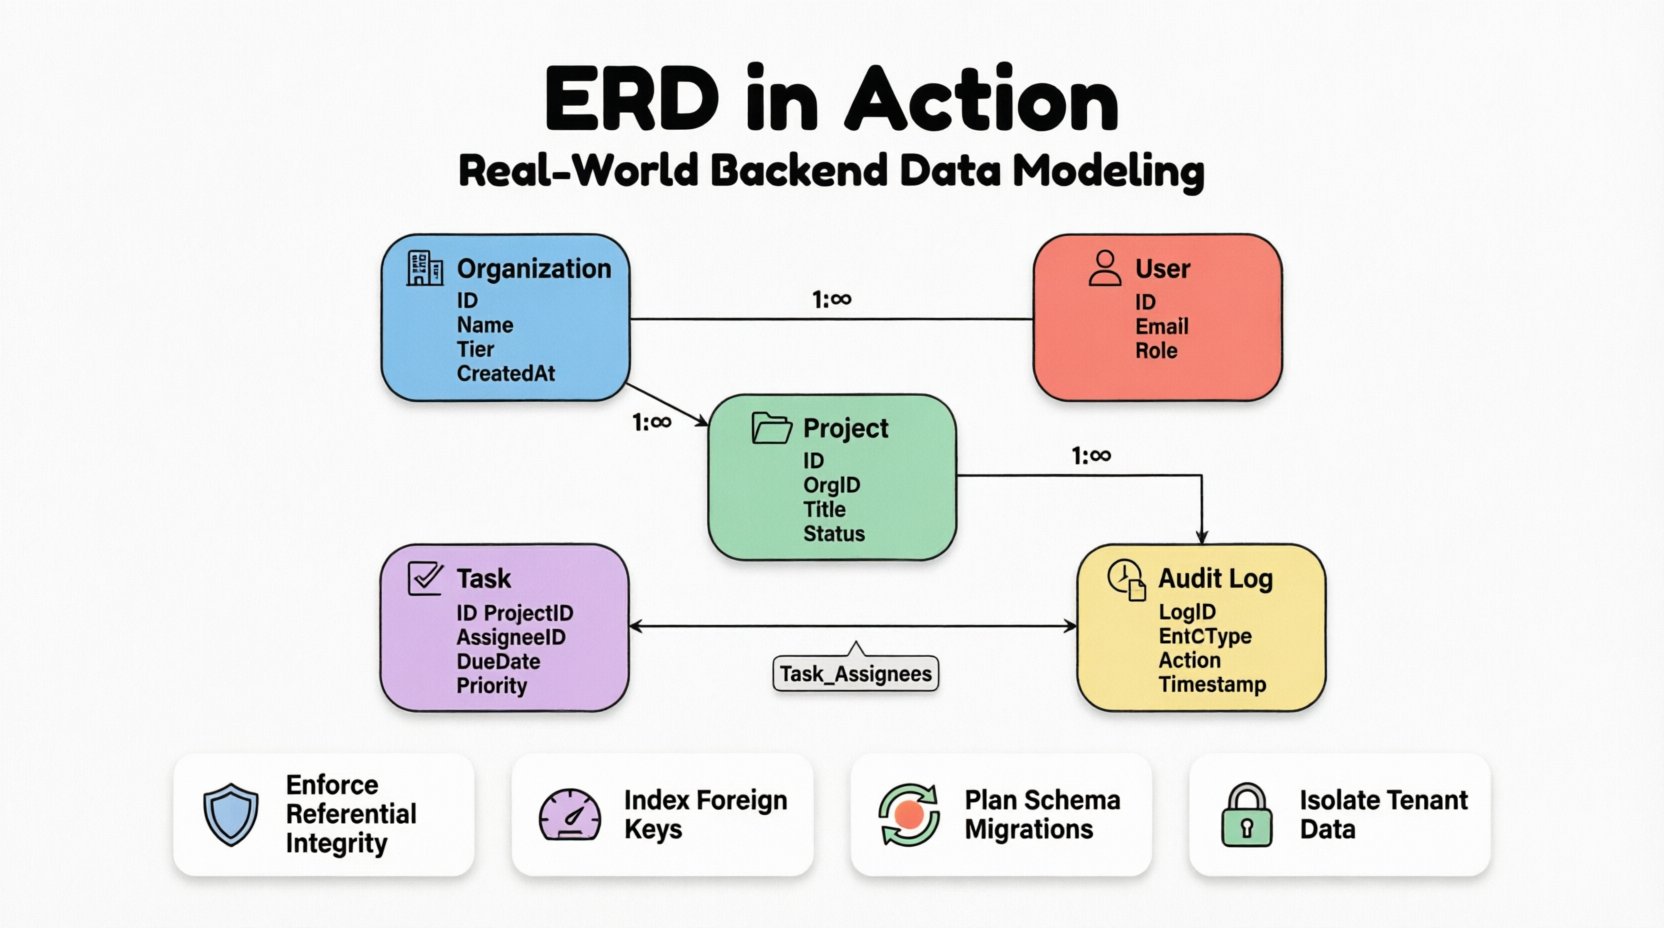
Projektowanie solidnego modelu danych to nie tylko ćwiczenie akademickie; jest fundamentem, na którym opiera się stabilność aplikacji. Diagram relacji encji (ERD) pełni rolę planu, określającego sposób przechowywania, łączenia i pobierania informacji w środowisku produkcyjnym. Gdy systemy skalują się, koszty słabego modelowania stają się wykładnicze. Niniejszy przewodnik analizuje praktyczną implementację ERD w złożonej architekturze backendowej, koncentrując się na integralności danych, skalowalności i utrzymaniu.
Zbyt często programiści koncentrują się na logice aplikacji, traktując bazę danych jako sprawę drugorzędną. Jednak schemat wyznacza granice tego, co system może efektywnie wykonywać. Analizując rzeczywisty scenariusz, możemy zrozumieć kompromisy związane z normalizacją danych, obsługą relacji i zapewnianiem integralności referencyjnej, bez polegania na konkretnych dostawcach oprogramowania.
📋 Scenariusz biznesowy
Rozważmy wieloklientową platformę usługową zaprojektowaną do zarządzania projektami współpracy. System wymaga ścisłej izolacji między różnymi organizacjami klientów, jednocześnie pozwalając na wewnętrzną elastyczność wewnątrz tych organizacji. Główne wymagania obejmują:
- Wieloklientowość:Dane muszą być segregowane według organizacji, aby zapewnić bezpieczeństwo.
- Złożone procesy biznesowe:Zadania muszą być przypisywane, śledzone i powiązane z konkretnymi projektami.
- Ścieżki audytowe:Każda istotna zmiana w rekordzie musi być logowana dla celów zgodności.
- Skalowalność:Schemat musi obsługiwać miliony rekordów bez pogorszenia wydajności zapytań.
Wyzwanie polega na przekształceniu tych zasad biznesowych w strukturę relacyjną, która zapobiega anomaliiom danych. Pospolitym błędem jest tworzenie struktur zbyt mocno znormalizowanych, które wymagają nadmiernych złączeń, lub struktur zbyt zdenormalizowanych, które prowadzą do redundancji danych i anomalii aktualizacji.
🔍 Podstawowe encje i atrybuty
Kręgosłupem każdego ERD jest definicja encji. W tym studium przypadku identyfikujemy pięć głównych encji. Każda encja reprezentuje odrębne pojęcie, które musi być utrwalone w bazie danych. Atrybuty powiązane z tymi encjami definiują ziarnistość przechowywanych danych.
1. Encja Organizacja
Jest to korzeń hierarchii. Każdy inny rekord jest powiązany z tą encją, aby wymusić izolację klienta.
- ID Organizacji:Unikalny identyfikator.
- Nazwa Organizacji:Czytelna dla człowieka etykieta.
- Poziom subskrypcji:Określa dostęp do funkcji.
- Utworzono w:Znacznik czasu do celów audytu.
2. Encja Użytkownik
Użytkownicy należą do organizacji, ale mogą być członkami wielu projektów. Dane uwierzytelniające są oddzielone od danych biznesowych, aby przestrzegać najlepszych praktyk bezpieczeństwa.
- ID Użytkownika:Unikalny identyfikator.
- E-mail: Służy do uwierzytelniania i kontaktu.
- Hasz hasła: Bezpieczne przechowywanie danych uwierzytelniających.
- Rola: Określa uprawnienia (Administrator, Członek, Przeglądający).
3. Encja projektu
Projekty są kontenerami na zadania. Są własnością organizacji, ale realizowane są przez użytkowników.
- ID projektu: Unikalny identyfikator.
- ID organizacji:Klucz obcy łączący z nadrzędnym dzierżawcą.
- Tytuł: Krótka nazwa projektu.
- Status: Aktywny, Zarchiwizowany lub Usunięty.
4. Encja zadania
Podstawowa jednostka pracy. Ta encja wymaga najbardziej złożonych relacji, ponieważ łączy użytkowników, projekty i logi.
- ID zadania: Unikalny identyfikator.
- ID projektu:Klucz obcy.
- ID wykonawcy:Klucz obcy do użytkownika.
- Termin wykonania:Ograniczenie czasowe.
- Priorytet:Wartość wyliczeniowa.
5. Encja logu audytowego
Rejestruje każdą zmianę wprowadzoną w krytycznych encjach. Zapewnia to śledzalność.
- ID logu: Unikalny identyfikator.
- Typ encji:Która tabela została zmieniona.
- ID rekordu:Który wiersz został zmieniony.
- Akcja:Utwórz, Zaktualizuj, Usuń.
- Wykonane przez:ID użytkownika.
- Czas:Czas wykonania akcji.
🔗 Modelowanie relacji i kardynalności
Relacje definiują sposób interakcji między encjami. W systemie produkcyjnym relacje te są egzekwowane za pomocą kluczy obcych. Kardynalność (jeden-do-jednego, jeden-do-wielu, wielu-do-wielu) określa sposób zapytywania i aktualizowania danych.
Organizacja do Użytkownika
Jest to jeden-do-wielu relacja. Jedna organizacja może mieć wielu użytkowników, ale rekord użytkownika jest powiązany z jedną organizacją w celu izolacji danych. Aby zapobiec wyciekowi danych między dzierżawcami, organization_id jest obowiązkowym kluczem obcym w tabeli Użytkownik.
Organizacja do Projektu
Podobnie, jest to jeden-do-wielu relacja. Projekty nie mogą istnieć bez nadrzędnej organizacji. Jeśli organizacja zostanie usunięta, zachowanie kaskadowe musi być starannie rozważone. W tym przypadku wybieramy miękkie usuwanie projektów zamiast ich twardego usuwania, aby zachować kontekst historyczny.
Projekt do Zadania
Kolejna jeden-do-wielu relacja. Projekt zawiera wiele zadań, a zadanie należy dokładnie do jednego projektu. Jest to standardowe połączenie strukturalne.
Użytkownik do Zadania (Przypisanie)
Jest to najważniejsza relacja. Użytkownik może być przypisany do wielu zadań, a zadanie może być przypisane do wielu użytkowników (praca zespołowa). Wymaga to Wiele do wielu relacja.
Aby to zaimplementować, wprowadzamy tabelę łączącą, często nazywaną encją asocjacyjną. Tabela ta przekształca relację wiele-do-wielu w dwie relacje jeden-do-wielu.
| Nazwa tabeli | Cel | Klucze |
|---|---|---|
| Task_Assignees | Łączy użytkowników z zadaniami | Task_ID, User_ID |
| Organization_Tenants | Łączy organizacje z użytkownikami | Organization_ID, User_ID |
Użycie tabeli łączącej pozwala nam przechowywać dodatkowe metadane. Na przykład w tabeliTask_Assignees możemy przechowywać rolę, jaką użytkownik pełnił w tym konkretnym zadaniu (np. Lider, Współtwórca), co różni się od jego globalnej roli użytkownika.
⚖️ Ograniczenia i integralność danych
Walidacja na poziomie aplikacji nie jest wystarczająca. Ograniczenia bazy danych działają jako ostateczna linia obrony przed uszkodzeniem danych. W środowisku produkcyjnym ograniczenia powinny być definiowane na poziomie schematu.
Integralność referencyjna
Klucze obce zapewniają, że rekord w tabeli podrzędnej nie może odnosić się do nieistniejącego rekordu nadrzędnego. Na przykład zadanie nie może być przypisane do użytkownika, który nie istnieje w systemie.
Jednak zachowaniaON DELETE orazON UPDATE są kluczowymi decyzjami:
- CASCADE: Jeśli rekord nadrzędny zostanie usunięty, wszystkie rekordy podrzędne zostaną również usunięte. Użyj tego dla danych osieroconych, które nie mają znaczenia bez rekordu nadrzędnego (np. komentarze do usuniętego posta).
- RESTRICT: Zapobiega usunięciu, jeśli istnieją rekordy podrzędne. Użyj tego, aby zapobiec przypadkowej utracie danych (np. usunięcie organizacji, która ma aktywne rekordy rozliczeniowe).
- SET NULL: Jeśli rekord nadrzędny zostanie usunięty, kolumna klucza obcego w tabeli podrzędnej zostanie ustawiona na NULL. Użyj tego, gdy relacja jest opcjonalna.
Ograniczenia sprawdzające
Standard SQL obsługuje ograniczenia sprawdzające do egzekwowania reguł specyficznych dla danej dziedziny. Przykłady obejmują:
- Termin wykonania: Kolumna
due_datemusi być większa niż kolumnacreated_at. - Priorytet: Kolumna
prioritymusi odpowiadać określonej liście dozwolonych wartości (np. Niski, Średni, Wysoki). - Kwota: Pola finansowe muszą być nieujemne.
Ograniczenia unikalności
Zapewnij unikalność danych tam, gdzie jest to wymagane. Na przykład adres e-mail musi być unikalny w całym systemie lub w ramach konkretnej organizacji, w zależności od modelu użytkownika. Złożone ograniczenie unikalności może zapewnić, że użytkownik jest przypisany do konkretnego projektu tylko raz (zapobiegając duplikatowi przypisań).
🚀 Strategia wydajności i indeksowania
Dobrze zaprojektowany schemat jest bezużyteczny, jeśli zapytania są wolne. Indeksowanie to mechanizm, który pozwala bazie danych szybko znajdować dane. Jednak indeksy wiążą się z kosztem w zakresie wydajności zapisu i zużycia pamięci.
Identyfikacja wzorców zapytań
Przed utworzeniem indeksów przeanalizuj najczęstsze operacje odczytu. W naszym studium przypadku typowe zapytania obejmują:
- Znajdź wszystkie zadania przypisane do konkretnego użytkownika.
- Znajdź wszystkie projekty w ramach organizacji.
- Pobierz logi audytowe dla konkretnego identyfikatora encji.
Umieszczanie indeksów
Klucze obce są najczęstszymi kandydatami do indeksowania. Jeśli zapytanie często filtruje według organization_id, indeks na tej kolumnie jest obowiązkowy. Bez niego baza danych wykonuje pełne skanowanie tabeli, co szybko pogarsza się wraz ze wzrostem danych.
Indeksy złożone są przydatne dla zapytań, które filtrują według wielu kolumn. Na przykład, jeśli system często szuka zadań według project_id OR status, indeks złożony na (project_id, status) jest bardziej wydajny niż dwa osobne indeksy.
Indeksy częściowe
W scenariuszach, w których często zapytywany jest tylko podzbiór danych, indeksy częściowe oszczędzają miejsce. Na przykład, jeśli system zapytuje tylko o aktywne zadania, indeks zawierający tylko wiersze, w których status = 'Aktywny' może być znacznie mniejszy i szybszy w przeglądaniu niż indeks na całej tabeli.
🛠️ Konserwacja i ewolucja schematu
Wymagania dotyczące oprogramowania się zmieniają. Schemat bazy danych nie jest wyjątkiem. Przejście z wersji A do wersji B wymaga starannego planowania, aby uniknąć przestojów i utraty danych. Proces ten jest często zarządzany za pomocą skryptów migracji.
Dodawanie kolumn
Dodanie nowej kolumny jest generalnie bezpieczne. Jeśli kolumna pozwala na wartości NULL, istniejące wiersze nie są dotknięte. Jeśli kolumna wymaga wartości domyślnej, upewnij się, że wartość ta jest zgodna ze wszystkimi istniejącymi danymi, aby uniknąć naruszeń ograniczeń.
Usuwanie kolumn
Usunięcie kolumny jest ryzykowne. Lepiej najpierw oznaczyć kolumnę jako przestarzałą. Pozwala to programistom na usunięcie odwołań do kolumny w kodzie aplikacji przed jej fizycznym usunięciem z bazy danych. To dwuetapowe podejście zapobiega błędom aplikacji w oknie wdrożenia.
Zmiana nazw kolumn
Zmiana nazw kolumn jest rzadko obsługiwana w starszych wersjach baz danych bez skomplikowanych obejść. Często lepiej jest dodać nową kolumnę z pożądaną nazwą, przemieścić dane, a następnie usunąć starą kolumnę. Zapewnia to, że schemat pozostaje kompatybilny wstecz w trakcie przejścia.
🚧 Typowe pułapki w projektowaniu ERD
Nawet doświadczeni architekci popełniają błędy. Zrozumienie typowych pułapek pomaga w ich unikaniu podczas fazy projektowej.
- Nadmierne normalizowanie:Podział danych na zbyt wiele małych tabel sprawia, że zapytania są złożone i wolne. Zrównoważ normalizację z wymaganiami dotyczącymi wydajności zapytań.
- Niedostateczne normalizowanie:Przechowywanie tych samych danych w wielu miejscach (np. powtarzanie nazw użytkowników w każdym logu zadań) prowadzi do anomalii aktualizacji. Jeśli użytkownik zmieni nazwę, musisz zaktualizować każdy wpis w logu.
- Zależności cykliczne:Tworzenie cyklicznych relacji kluczy obcych może prowadzić do zawieszeń podczas wstawiania lub usuwania. Upewnij się, że graf zależności jest skierowanym grafem acyklicznym (DAG).
- Ignorowanie miękkich usuwań:Twarde usuwanie rekordów usuwa historię. Wdroż kolumnę
deleted_atjako znacznik czasu, aby zachować widoczność rekordów dla celów audytowych, jednocześnie ukrywając je w standardowych widokach. - Jawnie określone typy danych:Używanie typów ogólnych, takich jak
VARCHAR(255)dla wszystkiego marnuje miejsce. UżyjINTdla identyfikatorów,BOOLEANdla flag, oraz specyficzne ograniczenia długości dla łańcuchów znaków tam, gdzie jest to odpowiednie.
✅ Najlepsze praktyki dla ERD w środowisku produkcyjnym
Aby zapewnić długowieczność i zdrowie systemu, przestrzegaj tych wytycznych:
- Dokumentuj relacje:Sam diagram ERD jest dokumentacją. Upewnij się, że jest on aktualizowany zgodnie z rzeczywistym schematem. Zautomatyzowane narzędzia mogą generować diagramy z bazy danych w celu weryfikacji dokładności.
- Standaryzuj konwencje nazewnictwa: Użyj
snake_casedla tabel i kolumn. Przedstawiaj klucze obce z nazwą relacji (np.organization_idzamiast tylkoorg_id) dla jasności. - Wybierz UUID vs Autoinkrementacja:W systemach rozproszonych UUID zapobiegają problemom z kolizjami podczas scalania baz danych. W systemach jednoinstancyjnych zautomatyzowane liczby całkowite są bardziej zwarte i szybsze.
- Planuj pod kątem wzrostu: Projektuj z myślą o partycjonowaniu. Jeśli tabela ma się rozrosnąć do miliardów wierszy, rozważ, jak zostanie podzielona między shardy lub partycje w oparciu o
organization_id. - Przeglądaj wzorce dostępu:Regularnie przeglądaj logi wolnych zapytań, aby zidentyfikować brakujące indeksy lub nieefektywne dołączenia.
🔄 Życie cyklu schematu
Diagram ERD nie jest dokumentem statycznym. Rozwija się wraz z produktem. Cykl życia zazwyczaj przebiega w następujących etapach:
- Etap projektowania:Tworzenie wstępnego modelu na podstawie wymagań.
- Faza implementacji:Tworzenie skryptów migracji w celu zbudowania schematu.
- Faza walidacji:Wykonywanie testów obciążeniowych w celu weryfikacji założeń wydajnościowych.
- Faza iteracji:Dodawanie nowych pól lub relacji w miarę wprowadzania nowych funkcji.
- Faza optymalizacji:Dopracowywanie indeksów i ograniczeń na podstawie danych produkcyjnych.
Podczas fazy optymalizacji możesz odkryć, że początkowe założenia dotyczące kardynalności były błędne. Na przykład możesz stwierdzić, że relacja typujeden-do-wieluw rzeczywistości jest relacją typuwielu-do-wieluw praktyce, co wymaga zmiany schematu na tabelę łączącą. To podkreśla znaczenie elastyczności w projektowaniu.
🛡️ Rozważania dotyczące bezpieczeństwa w projektowaniu schematu
Bezpieczeństwo danych jest ściśle powiązane z projektowaniem schematu. Polityki bezpieczeństwa na poziomie wierszy (RLS) często zależą od struktury diagramu ERD, aby działać poprawnie. Jeśliorganization_idnie jest odpowiednio zindeksowany i egzekwowany, użytkownik z Organizacji A może przypadkowo zapytać o dane Organizacji B.
Co więcej, dane wrażliwe powinny być oddzielone. Jeśli system obsługuje informacje o płatnościach, dane te powinny idealnie znajdować się w osobnym schemacie lub tabeli z bardziej rygorystycznymi kontrolami dostępu, zamiast być mieszane z ogólnymi danymi metadanych użytkowników. Ogranicza to zakres potencjalnych szkód w przypadku naruszenia bezpieczeństwa.
📝 Podsumowanie decyzji projektowych
Poniższa tabela podsumowuje kluczowe decyzje podjęte w tym studium przypadku oraz uzasadnienie stojące za nimi.
| Decyzja | Opcja A | Opcja B (Wybrana) | Uzasadnienie |
|---|---|---|---|
| Wielodostępność (Multi-Tenancy) | Oddzielne bazy danych | Wspólna baza danych, wspólny schemat | Zmniejszone nakłady operacyjne; łatwiejsze zarządzanie analityką międzydziałową. |
| Usuwanie organizacji | Trwałe usunięcie | Miękkie usunięcie | Zachowuje historyczne logi audytowe i zapobiega utracie danych w celu zapewnienia zgodności. |
| Przydziały zadań | Pojedyncza kolumna | Tabela łącząca | Umożliwia przypisanie wielu wykonawców i śledzenie konkretnych ról dla każdego przydziału. |
| Klucze główne | Automatyczne inkrementowanie | UUID-y | Obsługuje przyszłą architekturę rozproszoną i ułatwia scalanie danych. |
Tworzenie backendu produkcyjnego wymaga więcej niż tylko pisania kodu. Wymaga głębokiego zrozumienia przepływu danych i ich struktury. ERD to mapa, która prowadzi tę podróż. Postępując zgodnie z tymi zasadami, zapewniasz, że system pozostaje stabilny, bezpieczny i skalowalny wraz z rozwojem biznesu.
Pamiętaj, że celem nie jest stworzenie możliwie najbardziej złożonego diagramu, ale takiego, który najlepiej służy potrzebom aplikacji przy minimalizowaniu zadłużenia technicznego. Ciągłe przeglądy i adaptacja są kluczowe dla utrzymania zdrowego ekosystemu danych.