

एक मजबूत सूचना प्रणाली बनाना कोड लिखने से कम और संरचना को समझने से अधिक है। एक भी लाइन स्क्रिप्ट को चालू करने से पहले, एक भी तालिका बनाने से पहले, नींव रखी जानी चाहिए। यह नींव एंटिटी-रिलेशनशिप डायग्राम (Entity-Relationship Diagram) है, जिसे सामान्यतः ERD कहा जाता है। 🏗️ यह केवल एक चित्र नहीं है; यह एक तार्किक ब्लूप्रिंट है जो निर्धारित करता है कि डेटा कैसे प्रवाहित होता है, कैसे जुड़ता है और कैसे बना रहता है। कई डेवलपर इस चरण से जल्दी गुजर जाते हैं और इसे केवल एक औपचारिकता मानते हैं। यह एक गंभीर त्रुटि है। ERD के भीतर छिपी तर्कशक्ति पूरी एप्लिकेशन की प्रदर्शन क्षमता, स्केलेबिलिटी और अखंडता को निर्धारित करती है।
यह गाइड डेटाबेस मॉडलिंग की मौलिक यांत्रिकी का अन्वेषण करती है। हम सरल परिभाषाओं से आगे बढ़कर उस अंतर्निहित तर्क को समझेंगे जो डेटा संबंधों को नियंत्रित करता है। अंत तक, आप देखेंगे कि यहीं से शुरू करना केवल एक सुझाव नहीं, बल्कि किसी भी गंभीर तकनीकी प्रयास के लिए एक आवश्यकता क्यों है।
🔍 ERD क्या है और यह क्यों महत्वपूर्ण है?
एंटिटी-रिलेशनशिप डायग्राम (ERD) एक डेटाबेस की संरचना का दृश्य प्रतिनिधित्व है। यह एंटिटीज़ (वस्तुएं या अवधारणाएं) और उनके बीच के संबंधों को नक्शे पर उकेरता है। हालांकि यह सरल प्रतीत होता है, गहराई इन मैपिंग की सटीकता में निहित है। 📊
वैकल्पिक स्थिति पर विचार करें: बिना किसी योजना के तालिकाएं बनाना। आप एकusersतालिका और एकordersतालिका बना सकते हैं। लेकिन वे कैसे जुड़ते हैं? यदि कोई उपयोगकर्ता कोई ऑर्डर नहीं देता है तो क्या होता है? यदि एक ऑर्डर को कई उपयोगकर्ताओं से संबंधित होना आवश्यक हो तो क्या होगा? बिना किसी डायग्राम के, इन प्रश्नों का उत्तर प्रयोग और त्रुटि के माध्यम से दिया जाता है, जिससे अक्सर डेटा की अनावश्यकता या अखंडता की समस्याएं उत्पन्न होती हैं।
मुख्य घटक
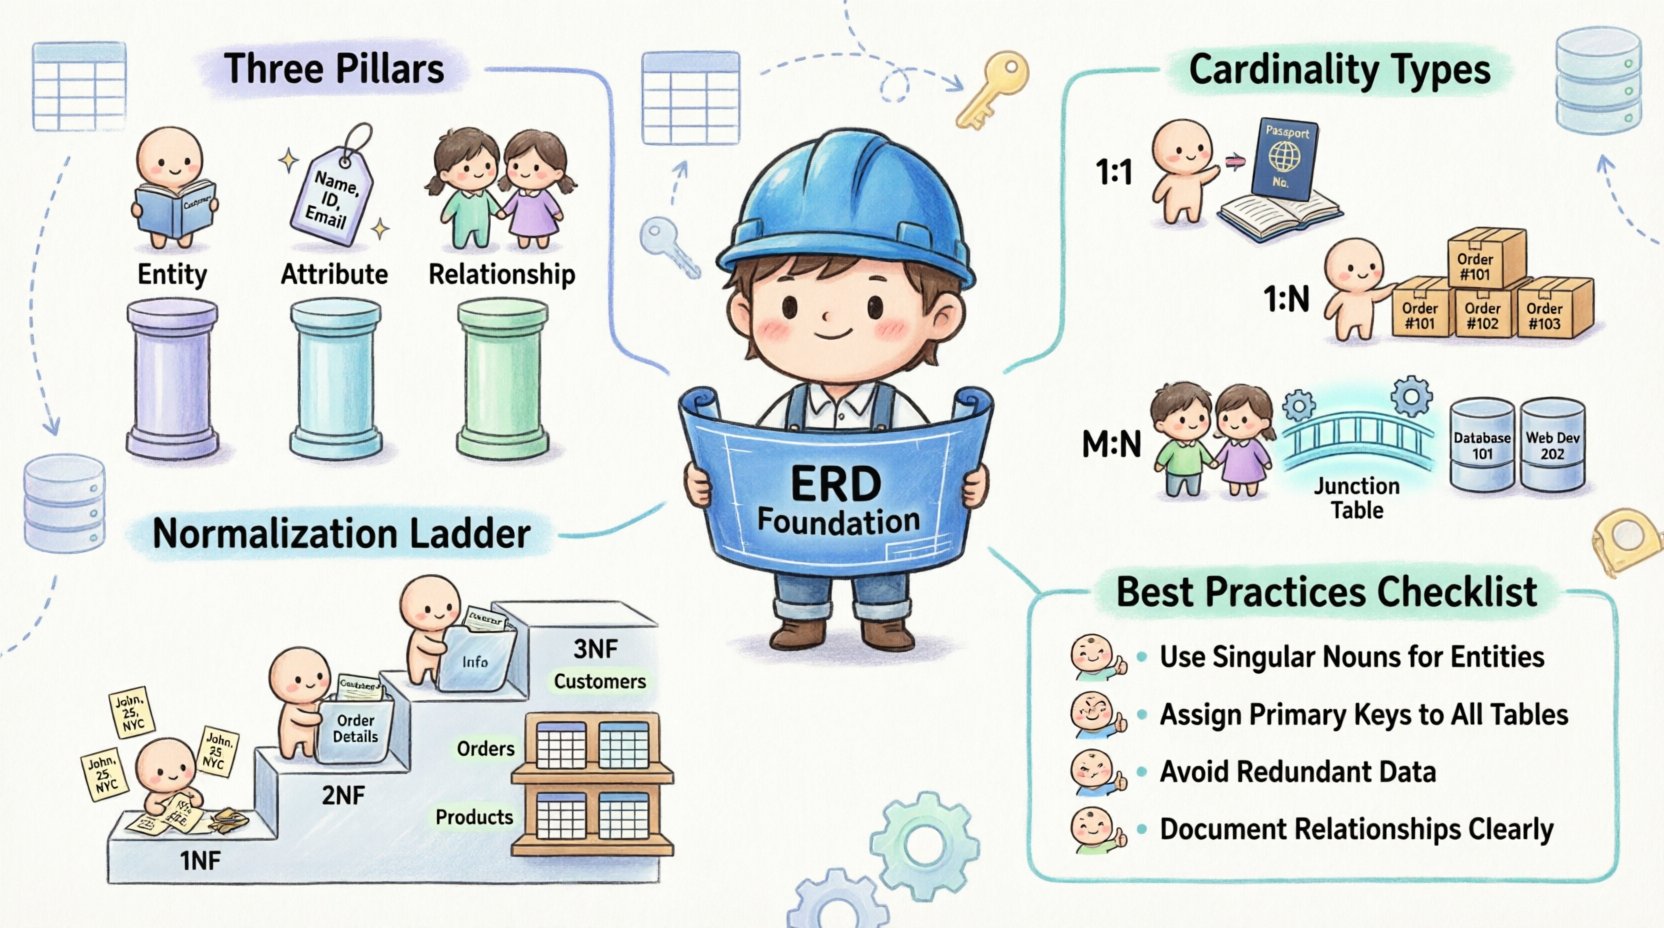
तर्क को समझने के लिए, हमें डायग्राम की संरचना का विश्लेषण करना होगा। प्रत्येक ERD तीन स्तंभों पर आधारित है:
-
एंटिटीज़:ये आपके सिस्टम के संज्ञाओं का प्रतिनिधित्व करते हैं। एक लाइब्रेरी सिस्टम में, ये हो सकते हैंBook, Author, औरMember. एक डेटाबेस में, ये सीधे तालिकाओं में अनुवादित होते हैं।
-
गुण:ये एंटिटीज़ का वर्णन करने वाले गुण हैं। एकBookके लिए, गुण शामिल हैंTitle, ISBN, औरPublication Date. ये आपकी तालिकाओं में कॉलम बन जाते हैं।
-
संबंध:ये परिभाषित करते हैं कि एंटिटीस एक-दूसरे के साथ कैसे बातचीत करते हैं। यही वह जगह है जहाँ तर्क रहता है। यह संबंध की कार्डिनैलिटी और बाधाओं को निर्दिष्ट करता है।
⚙️ कार्डिनैलिटी का तर्क
कार्डिनैलिटी डेटाबेस डिजाइन में सबसे अधिक गलत समझा जाने वाला अवधारणा है। यह केवल संख्याओं के बारे में नहीं है; यह नियमों के बारे में है। 📏 यह प्रश्न का उत्तर देता है: “एक एंटिटी के कितने उदाहरण दूसरे एंटिटी के उदाहरणों से संबंधित होते हैं?”
आपके डेटा की संरचना को परिभाषित करने वाले तीन प्रमुख प्रकार के संबंध हैं:
1. एक-से-एक (1:1)
यह संबंध तब होता है जब एक एंटिटी का एक उदाहरण दूसरे एंटिटी के ठीक एक उदाहरण से संबंधित होता है। यह दुर्लभ है, लेकिन विशिष्ट तार्किक आवश्यकताओं के लिए मौजूद है।
-
उदाहरण:एक व्यक्ति और एक पासपोर्ट. एक व्यक्ति के पास एक पासपोर्ट होता है। एक पासपोर्ट एक व्यक्ति का होता है।
-
लागू करने का तर्क:आप अक्सर इन्हें एक ही टेबल में विलय कर देते हैं या एक टेबल में विदेशी कुंजी का उपयोग करते हैं जो दूसरी टेबल की प्राथमिक कुंजी को संदर्भित करती है।
2. एक-से-अनेक (1:N)
यह डेटा मॉडलिंग में सबसे सामान्य संबंध है। एक एंटिटी दूसरे के कई उदाहरणों से संबंधित हो सकती है, लेकिन विपरीत सत्य नहीं है।
-
उदाहरण:एक ग्राहक और एक ऑर्डर. एक ग्राहक कई ऑर्डर दे सकता है। हालांकि, एक अकेला ऑर्डर केवल एक ग्राहक का होता है।
-
लागू करने का तर्क:विदेशी कुंजी को “अनेक” पक्ष पर रखी जाती है (“ऑर्डर टेबल) “एक” पक्ष को संदर्भित करने के लिए (“ग्राहक टेबल)।
3. अनेक-से-अनेक (M:N)
यह संबंध दर्शाता है कि एक एंटिटी के उदाहरण दूसरे के कई उदाहरणों से संबंधित हो सकते हैं, और इसके विपरीत भी।
-
उदाहरण: छात्र और पाठ्यक्रम. एक छात्र कई पाठ्यक्रमों में नामांकित हो सकता है। एक पाठ्यक्रम में कई छात्र हो सकते हैं।
-
लागू करने की तर्क: इसे सीधे संबंधित डेटाबेस में लागू नहीं किया जा सकता। इसके लिए एक जंक्शन टेबल (या सहसंबंध एंटिटी) की आवश्यकता होती है ताकि संबंध को दो एक-से-अनेक संबंधों में तोड़ा जा सके।
|
संबंध प्रकार |
तार्किक विवरण |
डेटाबेस लागू करना |
उदाहरण परिदृश्य |
|---|---|---|---|
|
एक-से-एक (1:1) |
एकल उदाहरण एकल उदाहरण से जुड़ा होता है |
दोनों पक्षों में से किसी एक पर विदेशी कुंजी |
कर्मचारी ↔ कार्यालय आवंटन |
|
एक-से-अनेक (1:N) |
एक उदाहरण कई उदाहरणों से जुड़ा होता है |
“अनेक” पक्ष पर विदेशी कुंजी |
विभाग ↔ कर्मचारी |
|
अनेक-से-अनेक (M:N) |
कई उदाहरण कई उदाहरणों से जुड़े होते हैं |
जंक्शन/सहसंबंध टेबल की आवश्यकता है |
शिक्षक ↔ विषय |
🔗 संबंधों और प्रतिबंधों को समझना
संबंध केवल आरेख पर रेखाएं नहीं हैं; वे व्यापारिक नियमों का प्रतिनिधित्व करते हैं। यदि आप अपने डिज़ाइन में इन नियमों का उल्लंघन करते हैं, तो आपका डेटा अविश्वसनीय हो जाता है। यहाँ कार्डिनैलिटी प्रतिबंध का उपयोग किया जाता है।
भागीदारी प्रतिबंध
ये निर्धारित करते हैं कि क्या किसी एंटिटी को किसी संबंध में भाग लेना अनिवार्य है। इसे आरेखों में अक्सर दोहरी रेखाओं द्वारा दर्शाया जाता है।
-
पूर्ण भागीदारी: एंटिटी A का प्रत्येक उदाहरण एंटिटी B के एक उदाहरण से संबंधित होना चाहिए। (उदाहरण: प्रत्येक ऑर्डर में एक ग्राहक होना चाहिए।)
-
आंशिक भागीदारी: एंटिटी A का एक उदाहरण एंटिटी B से संबंधित हो सकता है या नहीं भी हो सकता है। (उदाहरण: एक ग्राहक के पास क्रेडिट कार्ड हो सकता है या नहीं भी हो सकता है।)
संदर्भ अखंडता
ERD संदर्भ अखंडता को लागू करता है। यह सुनिश्चित करता है कि आप किसी ऐसे ग्राहक के लिए ऑर्डर नहीं बना सकते जो मौजूद नहीं है। विदेशी कुंजी प्रतिबंध एक गेटकीपर की तरह कार्य करता है, जिससे अनाथ रिकॉर्ड रोकते हैं। यह तर्क समय के साथ डेटा की संगति बनाए रखने के लिए अत्यंत महत्वपूर्ण है।
🧱 सामान्यीकरण और ERD
सामान्यीकरण को ध्यान में रखे बिना ERD का डिजाइन अधूरा है। सामान्यीकरण डेटा को व्यवस्थित करने की प्रक्रिया है ताकि अनावश्यकता कम हो और अखंडता में सुधार हो। ERD इन सामान्य रूपों को प्राप्त करने के लिए उपयोग किया जाने वाला दृश्य उपकरण है।
पहला सामान्य रूप (1NF)
पहला नियम परमाणुता है। प्रत्येक स्तंभ में केवल एक ही मान होना चाहिए। आपके ERD में “फ़ोन नंबर” के लिए एक स्तंभ नहीं होना चाहिए जिसमें एक ही सेल में तीन नंबर सूचीबद्ध हों। इसके बजाय, संबंध को विभाजित किया जाना चाहिए, या डेटा संरचना को कई प्रविष्टियों को समायोजित करने के लिए बदलना चाहिए।
दूसरा सामान्य रूप (2NF)
2NF, 1NF पर आधारित है और यह सुनिश्चित करता है कि सभी गैर-कुंजी विशेषताएं पूर्णतः प्राथमिक कुंजी पर निर्भर हों। यदि आपके पास कोई तालिका है जहाँ कुछ डेटा संयुक्त कुंजी के एक भाग पर निर्भर है, तो आपको तालिका को विभाजित करना होगा। ERD यह दर्शाकर इसकी कल्पना करने में मदद करता है कि कौन सी विशेषताएँ किस एंटिटी से संबंधित हैं।
तीसरा सामान्य रूप (3NF)
3NF संक्रमण निर्भरताओं को समाप्त करता है। यदि कोई गैर-कुंजी विशेषता किसी अन्य गैर-कुंजी विशेषता पर निर्भर है, तो यह इस रूप का उल्लंघन करता है। उदाहरण के लिए, यदि एक शहर एक पिन कोड पर निर्भर है, और पिन कोड पता पर निर्भर है, तो आपको शहर की जानकारी को अपनी स्वयं की एंटिटी या तालिका में अलग करना चाहिए।
इसका महत्व क्यों है: यदि आप सामान्यीकरण को छोड़ देते हैं, तो आपका ERD सरल दिख सकता है, लेकिन आपका डेटाबेस अस्त-व्यस्त हो जाएगा। अपडेट करना कठिन हो जाता है। रिकॉर्ड हटाने से अनजाने में आवश्यक डेटा भी हट सकता है। ERD का तर्क आपको इन संरचनात्मक दोषों से बचाता है।
🚫 सामान्य डिजाइन त्रुटियाँ
अनुभवी डिजाइनर भी फँस जाते हैं। इन चूक को शीघ्र पहचानने से महीनों के पुनर्लेखन की बचत होती है।
1. बहु-से-बहु (Many-to-Many) वास्तविकता को अनदेखा करना
बहु-से-बहु संबंधों को सीधे एक ही तालिका में बलपूर्वक डालने की कोशिश करना एक तार्किक त्रुटि है। इससे डेटा की प्रतिलिपियां और अस्पष्टता पैदा होती है। M:N संबंधों के लिए हमेशा एक सहयोगी एंटिटी (associative entity) का उपयोग करें।
2. अत्यधिक सामान्यीकरण (Over-Normalization)
हालांकि सामान्यीकरण अच्छा है, लेकिन इसका अत्यधिक उपयोग डेटा को अत्यधिक आक्रामक रूप से टुकड़ों में बांट देता है। इससे जटिल जोइन्स (joins) हो सकते हैं जो क्वेरी प्रदर्शन को कमजोर कर देते हैं। ERD को तार्किक शुद्धता और भौतिक प्रदर्शन के बीच संतुलन बनाए रखना चाहिए।
3. अस्पष्ट नामकरण परंपराएं
“Table1” या “Field1” जैसे नामों में कोई संदर्भ नहीं होता।Table1” या “Field1” कोई संदर्भ प्रदान नहीं करते। ERD तार्किकता को संचारित करने के लिए स्पष्ट नामकरण पर निर्भर करता है। व्यावसायिक डोमेन को प्रतिबिंबित करने वाले विवरणात्मक नामों का उपयोग करें।
4. गुणों की कमी
डिजाइनर अक्सर संबंधों पर ध्यान केंद्रित करते हैं और गुणों को भूल जाते हैं। बिना गुणों वाली तालिका केवल एक कंटेनर होती है। सुनिश्चित करें कि प्रत्येक एंटिटी में स्वतंत्र रूप से कार्य करने के लिए आवश्यक डेटा बिंदु हों।
✅ प्रभावी ERD के लिए सर्वोत्तम अभ्यास
एक विश्वसनीय मार्गदर्शक के रूप में कार्य करने वाले आरेख को बनाने के लिए, इन संरचित अभ्यासों का पालन करें।
-
एंटिटीज (Entities) से शुरुआत करें:सबसे पहले अपने सिस्टम के मुख्य वस्तुओं की पहचान करें। यह जानने तक संबंधों में फंसें नहीं कि क्या मौजूद है।
-
प्राथमिक कुंजियों (Primary Keys) को स्पष्ट रूप से परिभाषित करें:प्रत्येक तालिका को एक अद्वितीय पहचानकर्ता की आवश्यकता होती है। इन्हें स्पष्ट रूप से चिह्नित करें। यह संबंध तार्किकता को स्थिर करता है।
-
मानक संकेतन का उपयोग करें:चाहे आप ‘क्रो फुट’ (Crow’s Foot) संकेतन का उपयोग करें या ‘चेन’ (Chen) संकेतन, सुसंगतता ही मुख्य है। यह बाद में आरेख को पढ़ने वाले किसी भी व्यक्ति के लिए संज्ञानात्मक बोझ को कम करता है।
-
डिजाइन को पुनरावृत्त (Iterate) करें:ERD पहली ड्राफ्ट में दुर्लभ रूप से पूर्ण होता है। इसे व्यावसायिक आवश्यकताओं के खिलाफ पुनः समीक्षा करें। ऐसे प्रश्न पूछें, जैसे, “क्या एक उपयोगकर्ता के बिना पता हो सकता है?” और उसके अनुसार समायोजन करें।
-
तार्किकता को दस्तावेज़ित करें:जटिल नियमों को समझाने के लिए आरेख में नोट जोड़ें। तालिकाओं के बीच की रेखा आपको बताती है कि “क्या” जुड़ा हुआ है, लेकिन एक नोट आपको बताता है कि “क्यों.
🔄 तार्किकता से कार्यान्वयन तक
जब ERD को अंतिम रूप दे दिया जाता है, तो यह भौतिक स्कीमा के लिए सत्य का स्रोत बन जाता है। आरेख से डेटाबेस में संक्रमण वह स्थान है जहाँ तार्किकता को कोडित किया जाता है।
-
तार्किक से भौतिक: ERD तार्किक होता है। यह अवधारणाओं का वर्णन करता है। भौतिक स्कीमा भंडारण का वर्णन करता है। ERD को लक्ष्य प्रणाली के लिए उपयुक्त विशिष्ट डेटा प्रकारों (जैसे, Integer, Varchar, Date) में अनुवादित किया जाना चाहिए।
-
नियमों को कोड के रूप में: ERD में खींची गई संबंध विदेशी कुंजी प्रतिबंध डेटाबेस परिभाषा में। कार्डिनैलिटी जाँच प्रतिबंध या अद्वितीय सूचकांक बन जाती है।
-
सत्यापन:उत्पन्न स्कीमा का सत्यापन करने के लिए ERD का उपयोग करें। क्या प्रत्येक तालिका मौजूद है? क्या सभी संबंध संरक्षित हैं? क्या डेटा की अखंडता बनाए रखी गई है?
🛠️ रखरखाव पर प्रभाव
एक अच्छी तरह से संरचित ERD रखरखाव चरण में लाभ देता है। जब आवश्यकताएं बदलती हैं, तो आरेख प्रभावों की लहर दिखाता है।
-
प्रभाव विश्लेषण: यदि आपको किसी इकाई में एक नया क्षेत्र जोड़ने की आवश्यकता है, तो ERD दिखाता है कि कौन सी तालिकाएं उस परिवर्तन से प्रभावित हैं।
-
पुनर्निर्माण: यदि डेटाबेस धीमा हो जाता है, तो ERD संबंध पथों के आधार पर अक्षम जोड़ या अनुपलब्ध सूचकांकों की पहचान करने में मदद करता है।
-
दस्तावेज़ीकरण: ERD एक जीवंत दस्तावेज़ के रूप में कार्य करता है। नए टीम सदस्य आरेख का अध्ययन करके प्रणाली वास्तुकला को समझ सकते हैं।
📝 मुख्य अवधारणाओं का सारांश
संक्षेप में, ERDs के पीछे की तर्क स्पष्टता, अखंडता और संरचना के बारे में है। यहाँ आपके डिजाइन प्रक्रिया के लिए आवश्यक मुख्य बिंदु हैं:
-
इकाइयाँ मुख्य वस्तुओं का प्रतिनिधित्व करते हैं।
-
गुण उन वस्तुओं के गुणों को परिभाषित करते हैं।
-
संबंध वस्तुओं के बीच के संबंधों और नियमों को परिभाषित करते हैं।
-
कार्डिनैलिटी उन संबंधों की मात्रा निर्धारित करता है (1:1, 1:N, M:N)।
-
सामान्यीकरण सुनिश्चित करता है कि डेटा को अनावश्यकता को रोकने के लिए संगठित किया गया है।
-
प्रतिबंध आरेख में परिभाषित व्यापारिक नियमों को लागू करते हैं।
एंटिटी-रिलेशनशिप डायग्राम को अपने डेटाबेस डिज़ाइन की शुरुआती बिंदु के रूप में मानकर, आप सुनिश्चित करते हैं कि सिस्टम धारणाओं के बजाय तर्क के आधार पर बनाया गया है। यह दृष्टिकोण तकनीकी ऋण को कम करता है और एक स्केलेबल वास्तुकला बनाता है। सही रेखाएं खींचने का समय लें। अंदर का डेटा आपका शुक्रगुज़ार होगा। 🚀